Anime Rivals — SAE 2e année
Contexte : Projet de développement d'un jeu de cartes reposant sur des mécaniques stratégiques. L'objectif était de proposer une expérience équilibrée et intéressante grâce à différents comportements de jeu.
Ce qui a été fait : Conception et développement de plusieurs types de bots avec des stratégies distinctes : bot aléatoire, bot optimisé en début de partie, bot optimisé pour la fin de partie. Réflexion sur les choix algorithmiques afin de rendre les parties intéressantes et variées.
Difficultés : Trouver un équilibre entre difficulté et jouabilité a été un point central. Un bot trop performant rend le jeu frustrant, tandis qu'un bot trop faible enlève tout intérêt.
Ce qui a été appris : Ce travail a permis de développer une approche méthodique de résolution de problème, une réflexion algorithmique orientée stratégie, et une meilleure compréhension de l'équilibrage dans un système de jeu.
Ressenti : Partie particulièrement intéressante car elle demande de réfléchir en profondeur aux comportements et non seulement à l'implémentation technique.
Voir le projet →
Fête des Lumières 2025 — Compareur d'algorithmes de graphe
Contexte : Application Java développée en 2e année pour comparer des heuristiques de parcours (TSP). Le programme lit des fichiers TSP/TSPLIB (NODE_COORD_SECTION) et exécute plusieurs algorithmes pour produire des rapports CSV de performance.
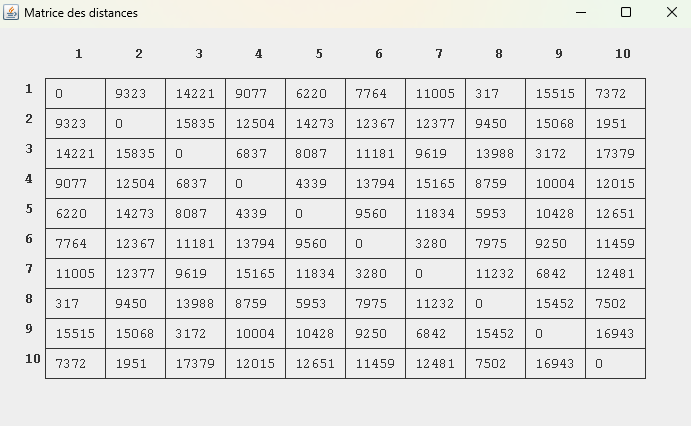
Ce que j'ai fait : J'ai implémenté et intégré plusieurs heuristiques obligatoires (glouton, insertion) ainsi qu'une heuristique libre inspirée des colonies de fourmis. J'ai aussi développé la gestion de la matrice des distances (EUC_2D et GEO) et la génération de rapports CSV comparatifs.
Difficultés : Normaliser les formats de coordonnées (EUC_2D vs GEO) et éviter les cycles dans les algorithmes. La mise au point de la simulation de colonies de fourmis a demandé beaucoup d'ajustements (dépôt/évaporation des phéromones, paramètres de convergence).
Ce qui a marché : Le comparateur calcule correctement les distances et identifie le meilleur trajet par jeu de données. J'ai appris à produire des sorties exploitables (CSV) et à automatiser les comparaisons.
Ressenti : Ce SAE m'a aidé à passer d'une logique algorithmique abstraite à une mise en œuvre concrète et mesurable. Travailler en condition d'examen m'a appris à structurer le code pour être fiable et reproductible.
Analyse algorithmique du gestionnaire de clients — Complexités et améliorations
Contexte : À partir du code C du gestionnaire de clients (SAE de première année), une analyse approfondie des performances et des complexités algorithmiques a été menée, dans le but d'optimiser les opérations critiques (recherche, tri, filtrage).
Ce qui a été fait : Pour chaque fonction, calcul de la complexité temporelle et spatiale :
- charger_clients : O(n) en temps (parcours du fichier), O(1) en espace (hors stockage).
- trier_clients : tri à bulles → O(n²) en temps (pire et moyen cas), O(1) en espace. Proposition de remplacer par
qsort (O(n log n)).
- rechercher_client : parcours linéaire O(n) ; discussion sur l'implémentation d'une table de hachage pour O(1) en moyenne.
- filtrer_clients : O(n) en temps, sans optimisation particulière.
Analyse des goulots d'étranglement (surtout le tri) et proposition d'algorithmes alternatifs (tri rapide, tri par fusion). Mise en place de tests de performance avec des jeux de données de plus en plus grands (100, 1 000, 10 000 clients) pour mesurer les écarts.
Difficultés : La mesure précise des temps d'exécution en C (utilisation de clock()), la génération de données aléatoires réalistes, et l'interprétation des résultats pour valider les modèles théoriques.
Ce qui a été appris : L'importance de choisir le bon algorithme en fonction de la volumétrie, la différence entre complexité théorique et pratique, et l'impact des opérations d'E/S sur les performances globales. Découverte des outils de profiling (gprof, valgrind).
Ressenti : Exercice très enrichissant qui fait le lien entre la théorie des algorithmes et le développement concret. Permet de prendre du recul sur son propre code et d'identifier les axes d'amélioration.